Une VPC paraît simple tant qu'elle ne contient qu'une application. On choisit un CIDR, on crée quelques subnets, une Internet Gateway, une NAT Gateway, et l'on passe au compute. Les limites apparaissent plus tard : un CIDR chevauche celui d'un autre environnement, une route devient difficile à expliquer, les subnets se retrouvent trop petits ou le coût NAT grimpe sans que personne ne sache quel trafic le provoque.
Le rôle du réseau n'est pas seulement de permettre aux workloads de communiquer. Il doit rendre les flux compréhensibles, limiter l'exposition et conserver de la marge pour les prochaines étapes : une nouvelle Availability Zone, un cluster Kubernetes, une connexion hybride ou plusieurs VPC.
Le CIDR est une décision d'architecture
Pour cette VPC, je pars de 10.0.0.0/16. Le bloc offre 65 536 adresses IPv4 théoriques. Le sujet n'est pas d'avoir beaucoup d'adresses ; c'est de les organiser sans créer de dette réseau.
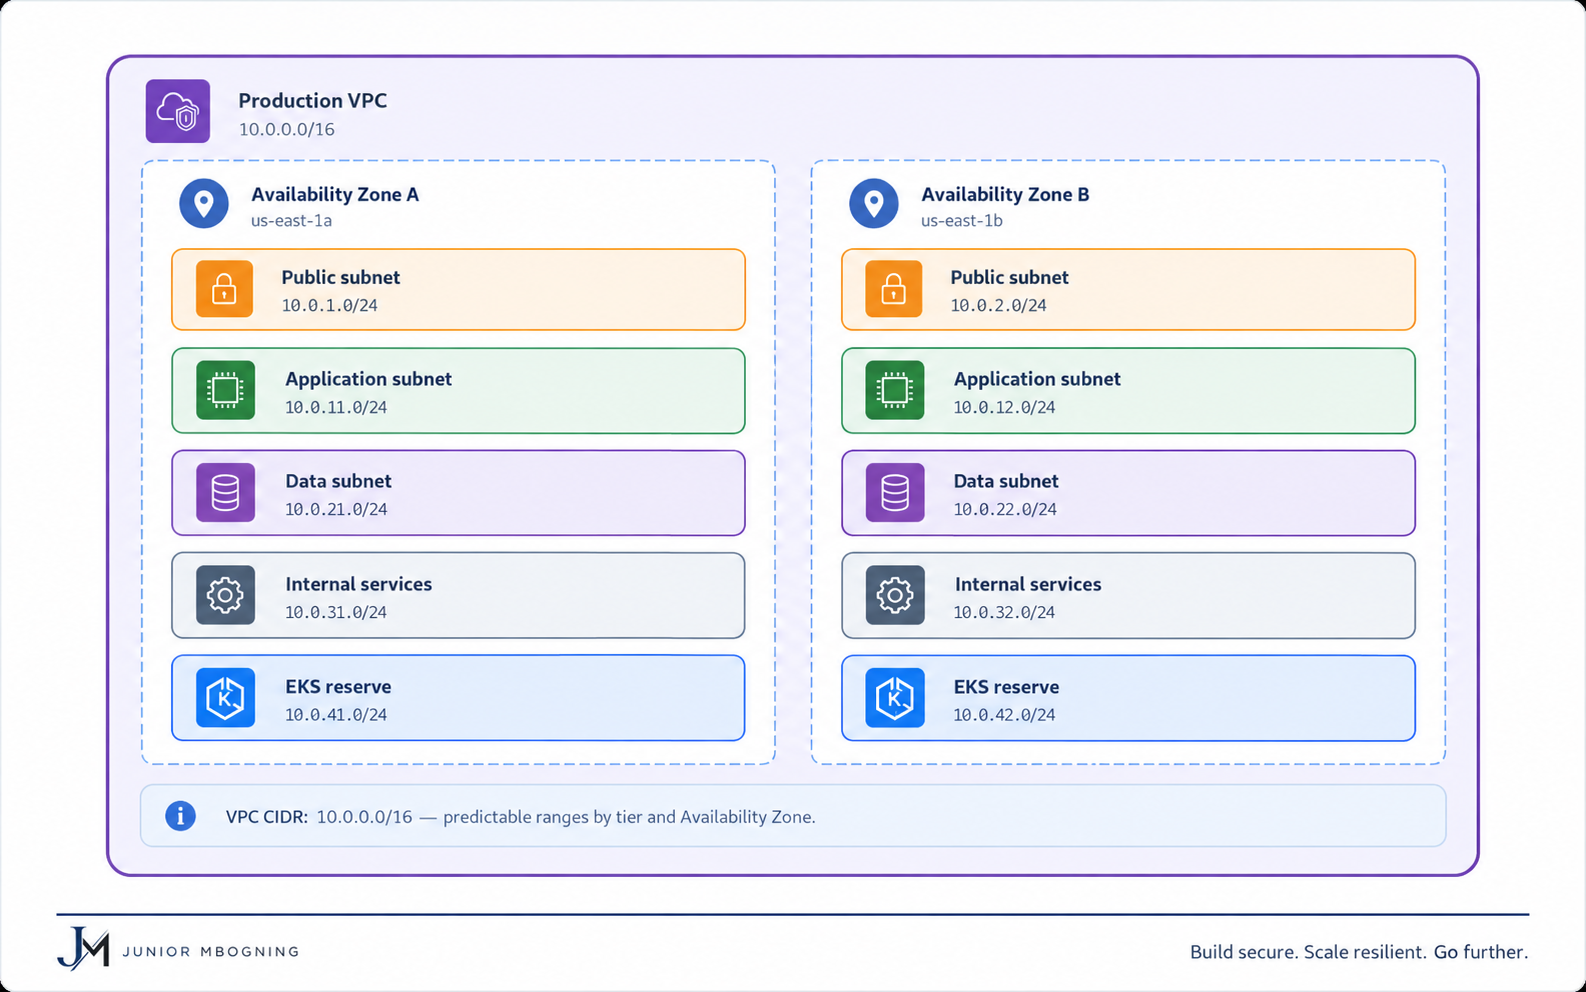
La convention est plus importante que les chiffres. Une adresse 10.0.21.x doit évoquer immédiatement la couche de données. Cette lisibilité devient utile dans les Flow Logs, dans les alertes et pendant un incident.
Le chevauchement CIDR est l'un des problèmes les plus coûteux à corriger. Deux VPC peuvent utiliser le même bloc tant qu'elles restent isolées. Le jour où l'on doit les relier par peering, Transit Gateway, VPN ou Direct Connect, le problème est déjà installé. Avant de réserver 10.0.0.0/16, je vérifie donc les plages utilisées par les autres environnements et par le réseau d'entreprise. À grande échelle, AWS VPC IP Address Manager aide à formaliser cette gouvernance.
Un /24 contient 256 adresses IPv4 ; AWS en réserve cinq. Les 251 adresses restantes sont confortables pour quelques instances EC2, mais le raisonnement change avec EKS, ECS ou Lambda dans une VPC. Le dimensionnement doit tenir compte des interfaces réseau, pas seulement du nombre de serveurs visibles.
Les routes donnent leur sens aux subnets
Le mot « privé » est souvent trop vague. Je distingue trois comportements :
Public
10.0.0.0/16 -> local
0.0.0.0/0   -> Internet Gateway

Privé avec sortie Internet
10.0.0.0/16 -> local
0.0.0.0/0   -> NAT Gateway

Isolé
10.0.0.0/16 -> local
Un subnet applicatif peut être privé tout en ayant besoin de joindre une API externe. Un subnet de données peut ne disposer d'aucun chemin vers Internet. La table de routage décrit ce comportement avec bien plus de précision que le nom du subnet.
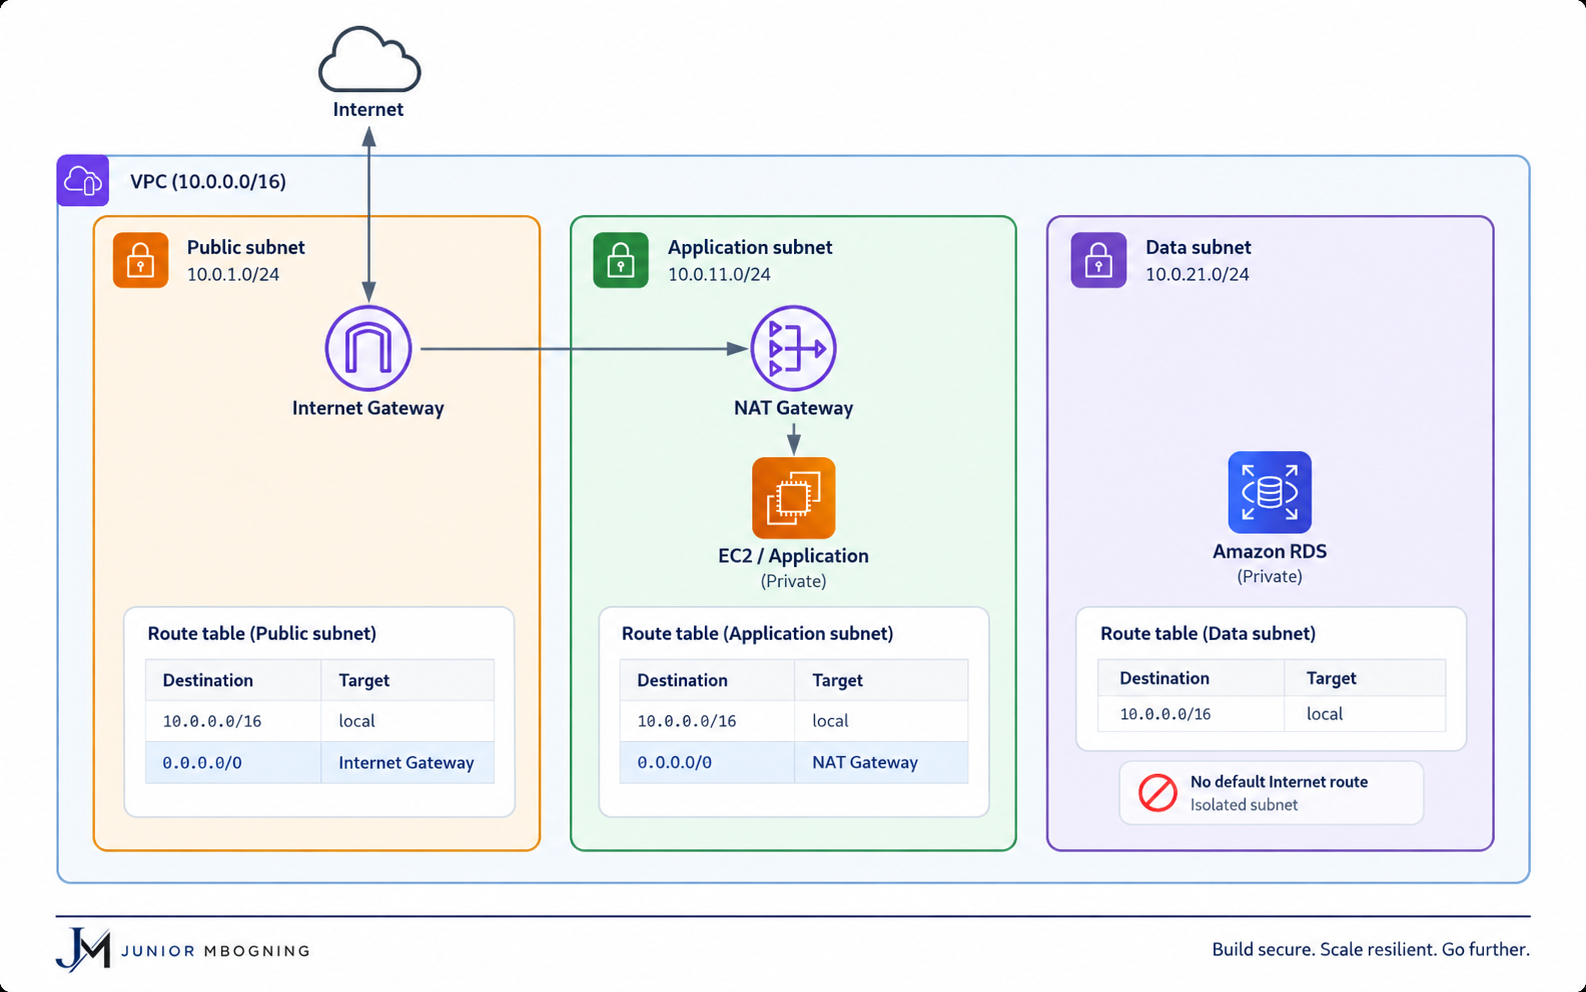
L'Internet Gateway rend possible le trafic Internet pour les ressources dont les routes l'autorisent. Sa présence sur une VPC ne rend pas automatiquement ses ressources publiques.
resource "aws_route" "public_internet" {
  route_table_id         = aws_route_table.public.id
  destination_cidr_block = "0.0.0.0/0"
  gateway_id             = aws_internet_gateway.main.id
}
La règle de longest prefix match est essentielle. Avec 10.0.0.0/16 -> local et 0.0.0.0/0 -> NAT, le trafic vers 10.0.21.40 reste dans la VPC alors que le trafic vers 8.8.8.8 prend la route par défaut. Une route plus spécifique, par exemple 10.0.21.0/24, l'emporte sur le /16.
J'associe explicitement les subnets à leurs tables de routage dans Terraform. Un subnet qui utilise accidentellement la Main Route Table est une surprise inutile lors d'une évolution future.
NAT Gateway : utile, mais pas par défaut pour tous les flux
Une NAT Gateway permet aux workloads privés de sortir sans recevoir de connexions entrantes depuis Internet. Le modèle zonal place une NAT dans chaque Availability Zone afin d'éviter qu'une zone dépende de la sortie réseau d'une autre. Ce modèle améliore l'isolation zonale, mais il a un coût fixe et un coût de traitement des données.
Les NAT Gateways régionales peuvent simplifier l'egress multi-AZ. Elles ne couvrent pas les cas de connectivité privée, qui restent un motif de conserver une NAT zonale. La bonne question n'est donc pas « une NAT par AZ ou une seule NAT ? », mais « quel chemin doit prendre ce flux et quel niveau de disponibilité lui faut-il ? ».
La NAT ne doit pas devenir le passage obligé de tout trafic sortant. Pour S3 et DynamoDB, un Gateway VPC Endpoint s'intègre aux tables de routage. Pour de nombreux autres services AWS, un Interface Endpoint utilise PrivateLink et des interfaces réseau privées.
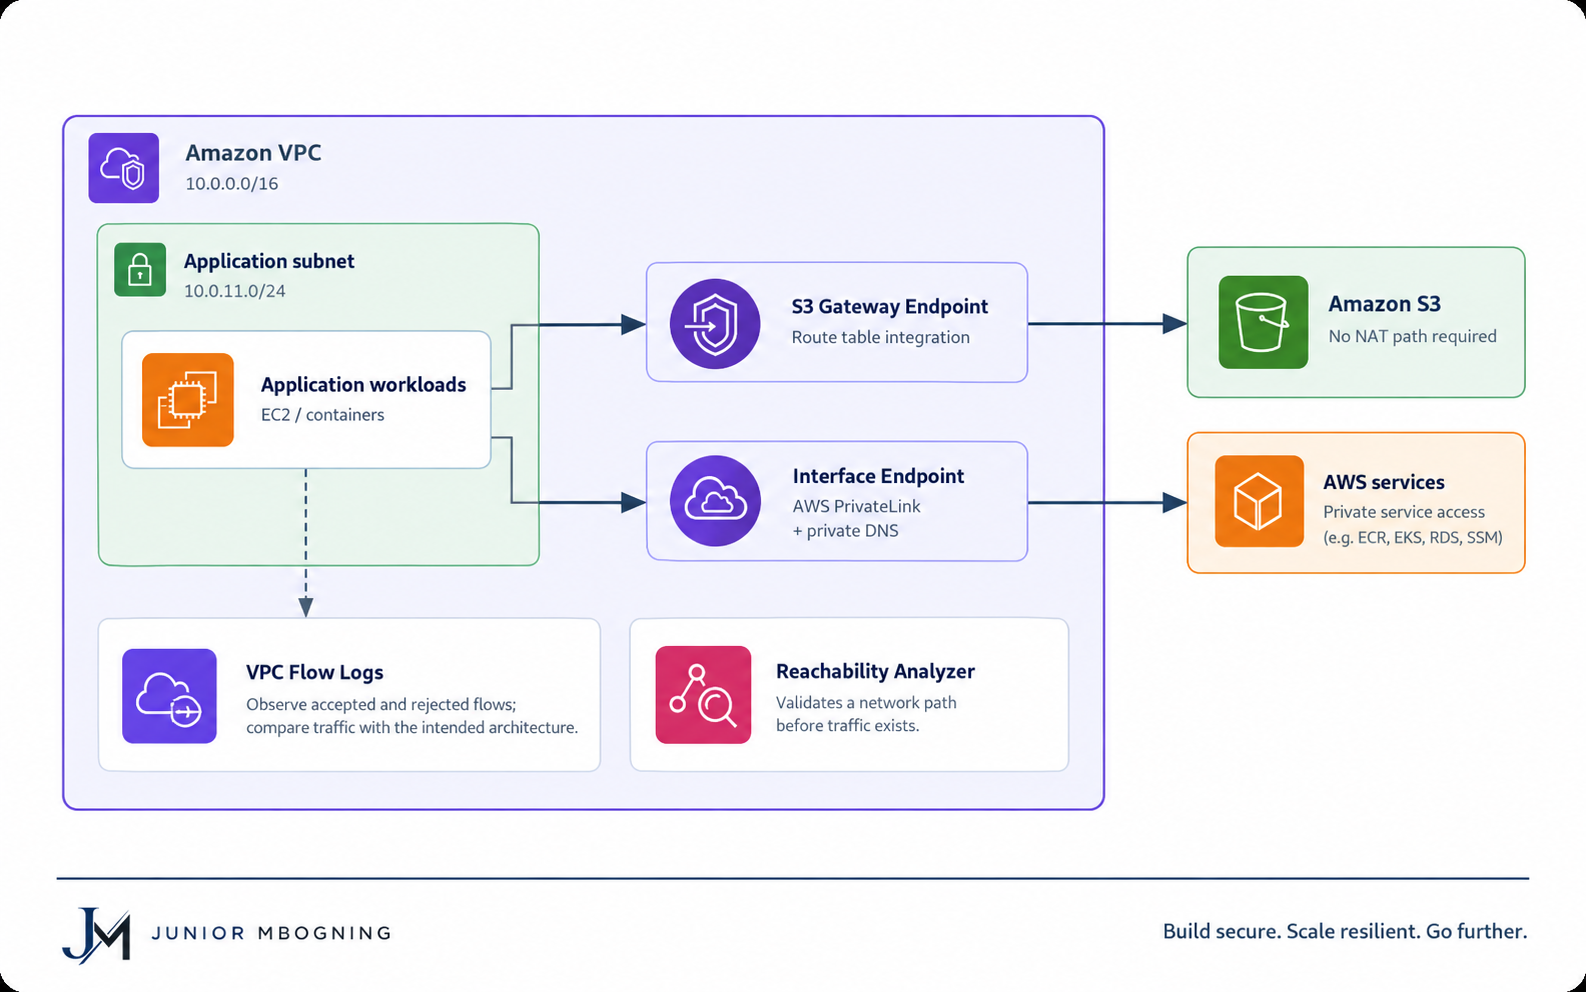
Le choix entre un Interface Endpoint et le chemin NAT dépend du volume, du nombre de zones, des exigences DNS, du niveau de sécurité recherché et du coût total. Créer un endpoint pour chaque service sans mesurer le trafic n'est pas une stratégie ; c'est simplement déplacer la facture.
DNS, Security Groups et NACL : trois sujets à ne pas mélanger
Le DNS est un composant réseau. RDS utilise un endpoint DNS, les Interface Endpoints s'appuient sur le DNS privé, et une architecture hybride finit souvent par avoir besoin de zones privées, de règles de forwarding et de Resolver Endpoints. Je conserve donc enable_dns_support et enable_dns_hostnames activés, puis je documente les conventions de nommage et les zones Route 53 dès que le périmètre s'élargit.
Les Security Groups restent le contrôle principal autour des workloads. Ils sont stateful et permettent d'exprimer une relation entre systèmes : ALB-SG -> APP-SG -> DB-SG. Cette intention est généralement plus claire qu'une succession de grandes plages CIDR.
Les Network ACLs opèrent au niveau du subnet et sont stateless. Elles ont leur place lorsqu'un contrôle subnet-level est réellement nécessaire, mais une NACL complexe ajoutée par principe rend le diagnostic difficile. Lors d'un incident, il faut pouvoir déterminer rapidement si le blocage vient d'une route, d'un Security Group, d'une NACL, d'une endpoint policy ou du DNS.
Observer et tester le réseau avant qu'il ne devienne opaque
Reachability Analyzer répond à une question précise : existe-t-il un chemin théorique entre deux composants ? Une EC2 privée vers RDS sur 5432 doit être atteignable. Internet vers une EC2 privée sur 22 doit être non atteignable. L'outil ne remplace pas un test applicatif, mais il isole rapidement le composant qui bloque un flux.
Les VPC Flow Logs complètent cette analyse en montrant les flux réels. Ils permettent de distinguer un ACCEPT attendu d'un REJECT révélant une règle manquante ou une tentative d'accès non souhaitée. Les diagrammes décrivent l'intention ; les Flow Logs montrent ce qui se produit réellement.
Préparer l'étape suivante
Une VPC isolée reste simple. Lorsque plusieurs VPC apparaissent, les questions changent : VPC Peering ou Transit Gateway ? Egress centralisé ou distribué ? Où placer l'inspection firewall, le DNS, les logs et les endpoints ? À ce stade, le réseau devient une plateforme interne avec ses propres conventions et son cycle de vie.
IPv6 mérite la même anticipation. AWS permet le dual-stack sur de nombreux services, mais le modèle de sortie diffère d'IPv4 : une Egress-Only Internet Gateway autorise des connexions sortantes IPv6 sans ouvrir arbitrairement les entrées. Prévoir ce point tôt évite d'ajouter IPv6 comme un correctif tardif.
Conclusion
Un bon VPC n'est pas celui qui contient le plus de subnets ou de services réseau. C'est celui dont l'équipe peut expliquer chaque plage IP, chaque route et chaque dépendance NAT.
Avant de considérer le réseau terminé, je vérifie au minimum les sorties Internet nécessaires, les chemins explicitement refusés, l'accès aux données sur les bons ports, le recours aux endpoints prévus et la disponibilité des plages IP. Le code Terraform décrit le résultat ; les tests et les Flow Logs confirment que le réseau se comporte comme prévu.
Discussion
Commentaires
Les lecteurs peuvent réagir, poser une question ou prolonger l'échange. Une connexion GitHub est demandée pour publier un commentaire.