Une application web peut démarrer sur une unique instance EC2. Ce choix est souvent raisonnable au lancement d'un produit : il réduit le coût, la complexité et le temps de mise en ligne. Il devient insuffisant dès que l'application doit rester disponible pendant un déploiement, un incident d'infrastructure ou une hausse de trafic.
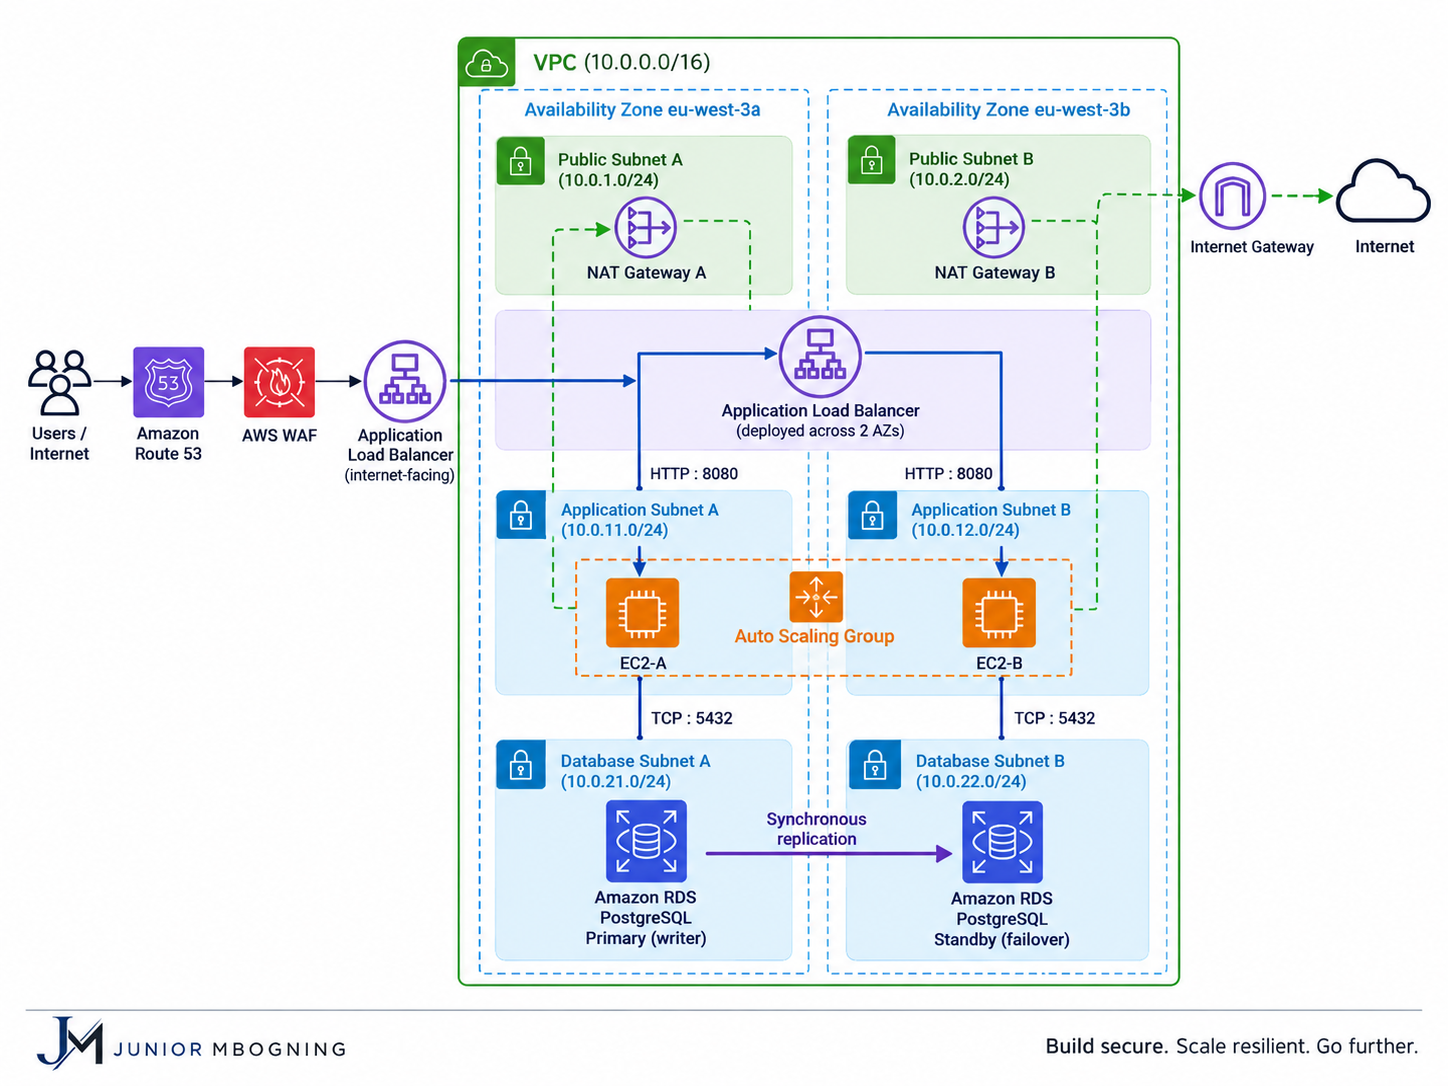
Le passage à une architecture 3-tiers ne consiste pas à ajouter des services AWS au diagramme. Il consiste à séparer les responsabilités et à rendre chaque chemin réseau explicite : l'utilisateur atteint le point d'entrée, le point d'entrée joint l'application, et l'application seule accède à la base de données.
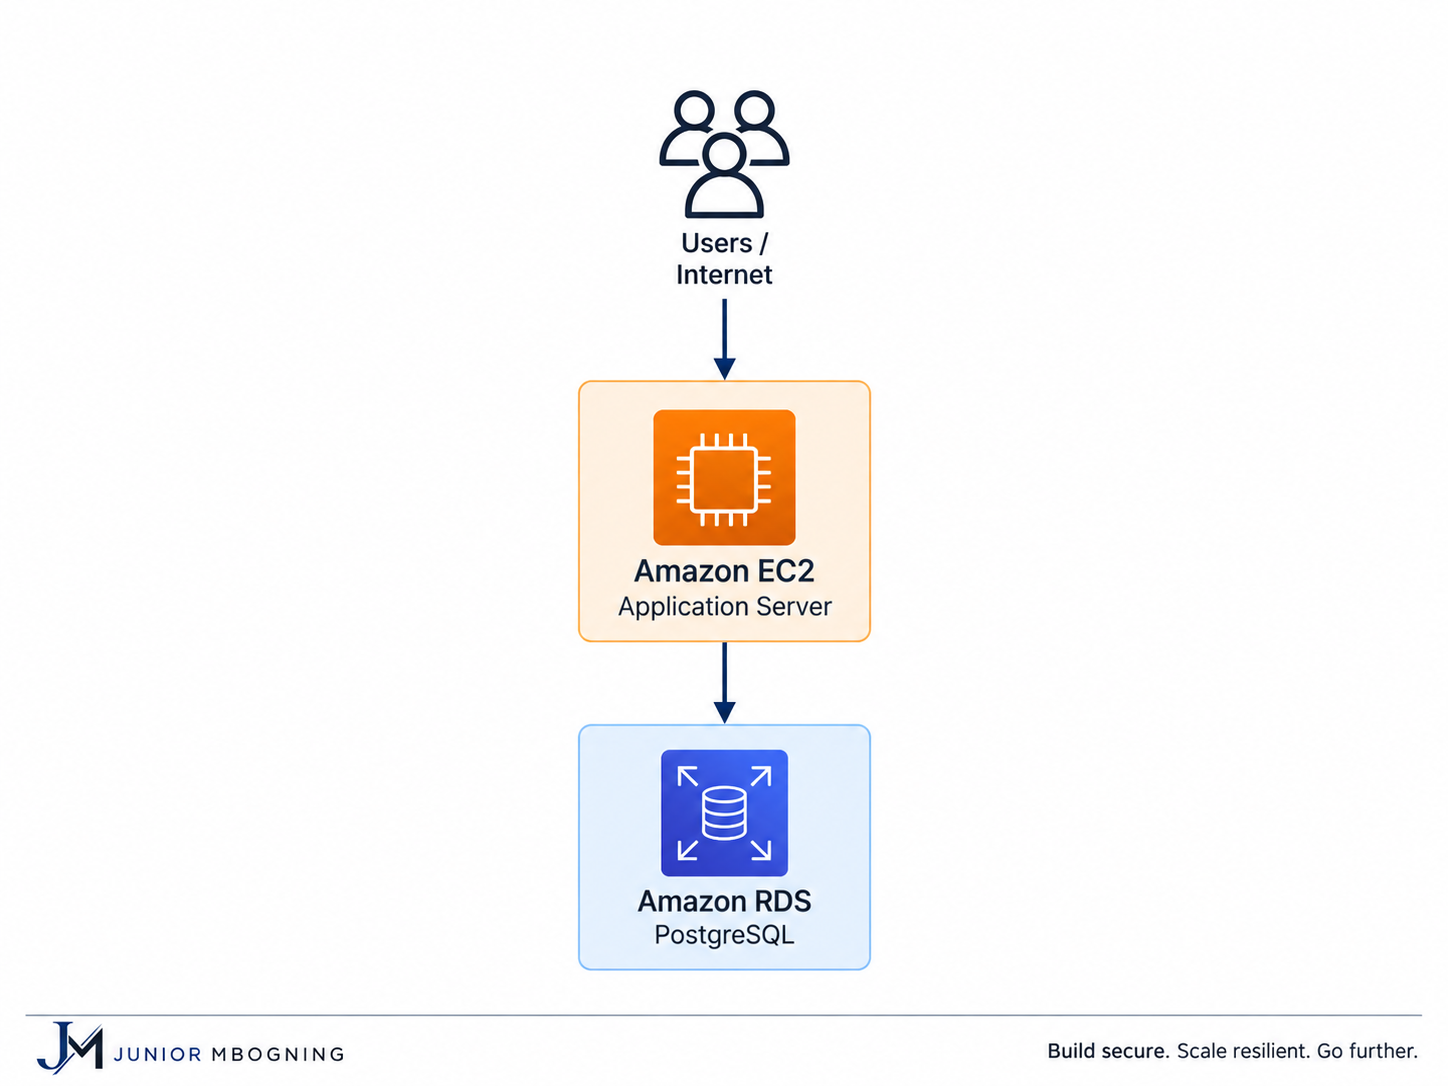
Le scénario étudié est volontairement simple : une application HTTP, un backend sur EC2 et PostgreSQL sur RDS. L'infrastructure est décrite avec Terraform. EC2 n'est pas présenté comme le meilleur choix dans tous les contextes ; ici, il permet d'isoler les sujets qui comptent : routage, load balancing, health checks, Auto Scaling et failover. Une plateforme déjà conteneurisée pourra naturellement s'appuyer sur ECS ou EKS.
Le réseau fixe les limites de l'architecture
Je pars d'une VPC en 10.0.0.0/16, puis je réserve un subnet public, un subnet applicatif et un subnet de données dans chaque Availability Zone.
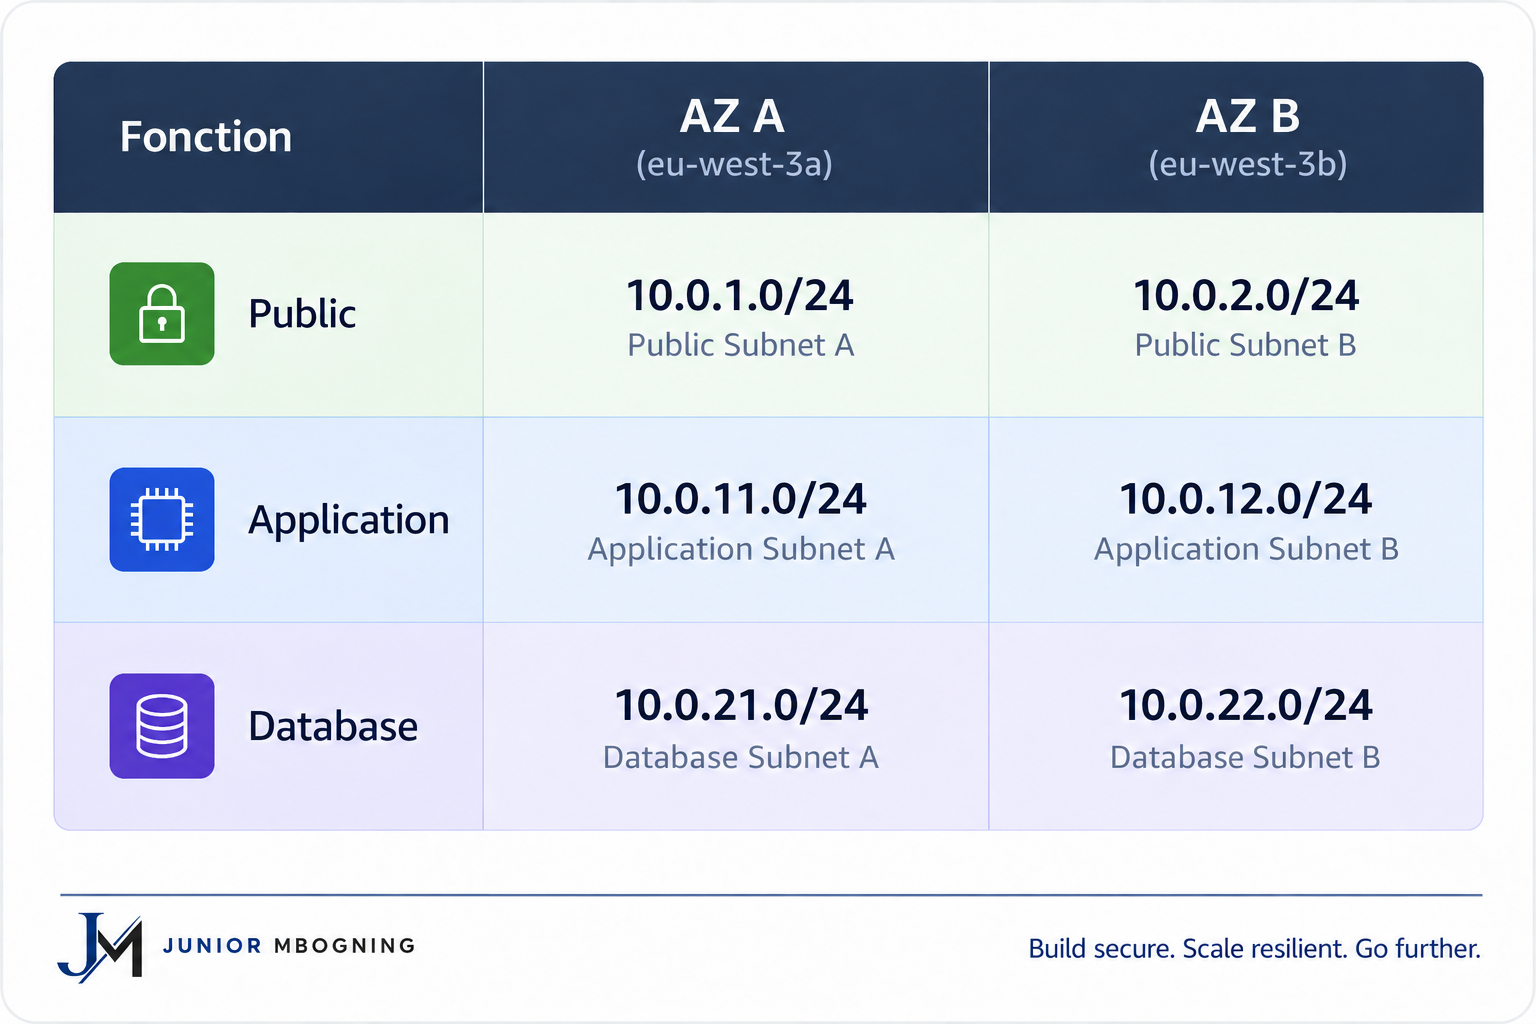
Cette convention n'a rien de particulier. Elle est utile parce qu'elle reste lisible. Une adresse 10.0.12.x identifie immédiatement une ressource applicative de la seconde zone ; c'est précieux lorsqu'on analyse un Flow Log ou un incident plusieurs mois après le déploiement.
Le /16 laisse de la marge pour de nouveaux environnements, une connexion hybride ou un futur cluster Kubernetes. Ce point mérite d'être traité tôt : un mauvais plan CIDR se corrige beaucoup moins facilement qu'une AMI ou qu'un type d'instance.
resource "aws_vpc" "main" {
  cidr_block           = "10.0.0.0/16"
  enable_dns_support   = true
  enable_dns_hostnames = true

  tags = {
    Name        = "production-vpc"
    Environment = "production"
    ManagedBy   = "terraform"
  }
}
Un subnet /24 offre 251 adresses IPv4 utilisables après la réservation AWS. C'est largement suffisant pour ce cas. Ce calcul doit être revu avec EKS, ECS ou Lambda dans une VPC : ces services peuvent consommer des adresses par l'intermédiaire de nombreuses interfaces réseau.
Chaque subnet appartient à une seule Availability Zone. La haute disponibilité se prépare donc dans le réseau avant d'être confiée à l'Auto Scaling Group.
Le routage définit ce qui est public et ce qui ne l'est pas
Le nom d'un subnet ne lui donne aucun droit. C'est sa table de routage qui définit son comportement.
Public
10.0.0.0/16 -> local
0.0.0.0/0   -> Internet Gateway

Privé avec sortie Internet
10.0.0.0/16 -> local
0.0.0.0/0   -> NAT Gateway

Isolé
10.0.0.0/16 -> local
Les subnets publics hébergent l'Application Load Balancer et, dans le modèle zonal, les NAT Gateways. Les instances EC2 résident dans les subnets applicatifs. Elles peuvent sortir pour joindre un dépôt de paquets ou une API externe, sans être directement accessibles depuis Internet. Les subnets de base de données n'ont pas de route par défaut vers Internet.
resource "aws_route" "public_internet" {
  route_table_id         = aws_route_table.public.id
  destination_cidr_block = "0.0.0.0/0"
  gateway_id             = aws_internet_gateway.main.id
}
Le longest prefix match explique la circulation des paquets. Avec une route locale 10.0.0.0/16 et une route par défaut 0.0.0.0/0 vers une NAT Gateway, une requête à destination de 10.0.21.40 reste dans la VPC. Une requête vers 8.8.8.8 suit la route par défaut. Cette règle suffit à expliquer une grande partie des erreurs de routage observées en pratique.
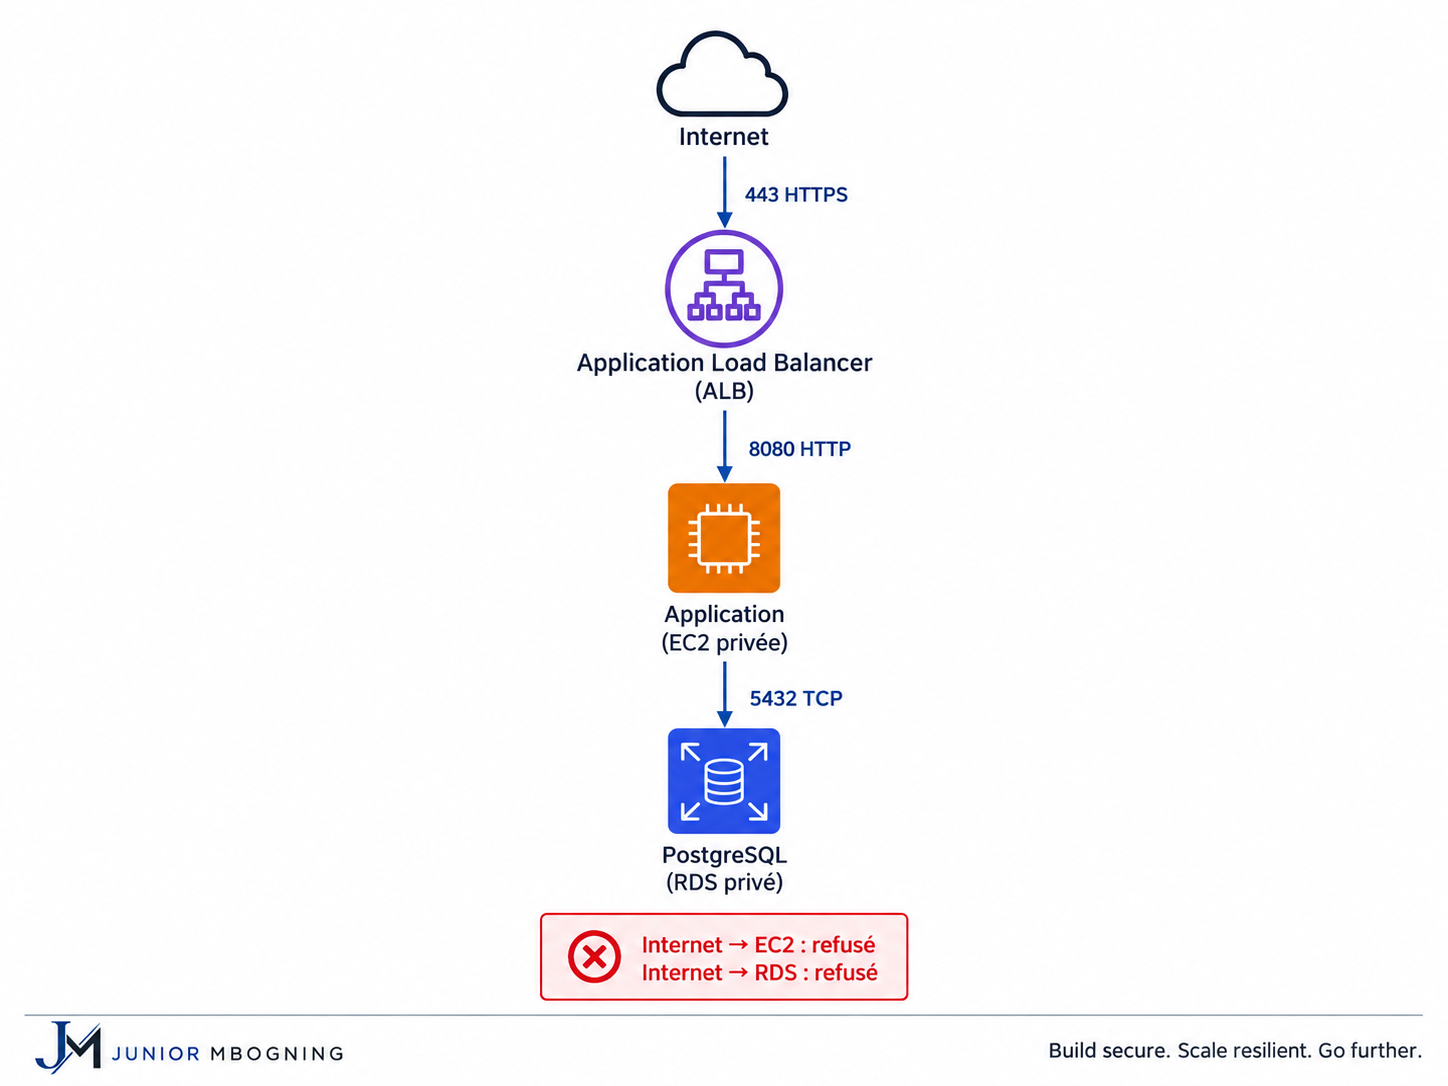
Une entrée publique, des instances privées
L'Application Load Balancer est le seul composant applicatif exposé. Il reçoit le trafic HTTPS et le distribue vers les instances saines des deux zones.
Internet -> Application Load Balancer -> EC2 privée
Les instances n'ont pas d'IPv4 publique. Ce choix élimine une surface d'attaque inutile et impose un chemin d'entrée unique, observable et contrôlable. Les accès d'administration passent par Systems Manager plutôt que par un port SSH ouvert sur Internet.
Les instances ont néanmoins besoin de sorties. Une NAT Gateway zonale par Availability Zone conserve l'affinité entre le workload et sa sortie réseau. AWS propose également des NAT Gateways régionales, qui peuvent simplifier une architecture répartie sur plusieurs zones. Elles ne répondent toutefois pas aux besoins de connectivité privée ; il faut donc choisir le modèle en fonction des flux réels, pas d'une règle générale.
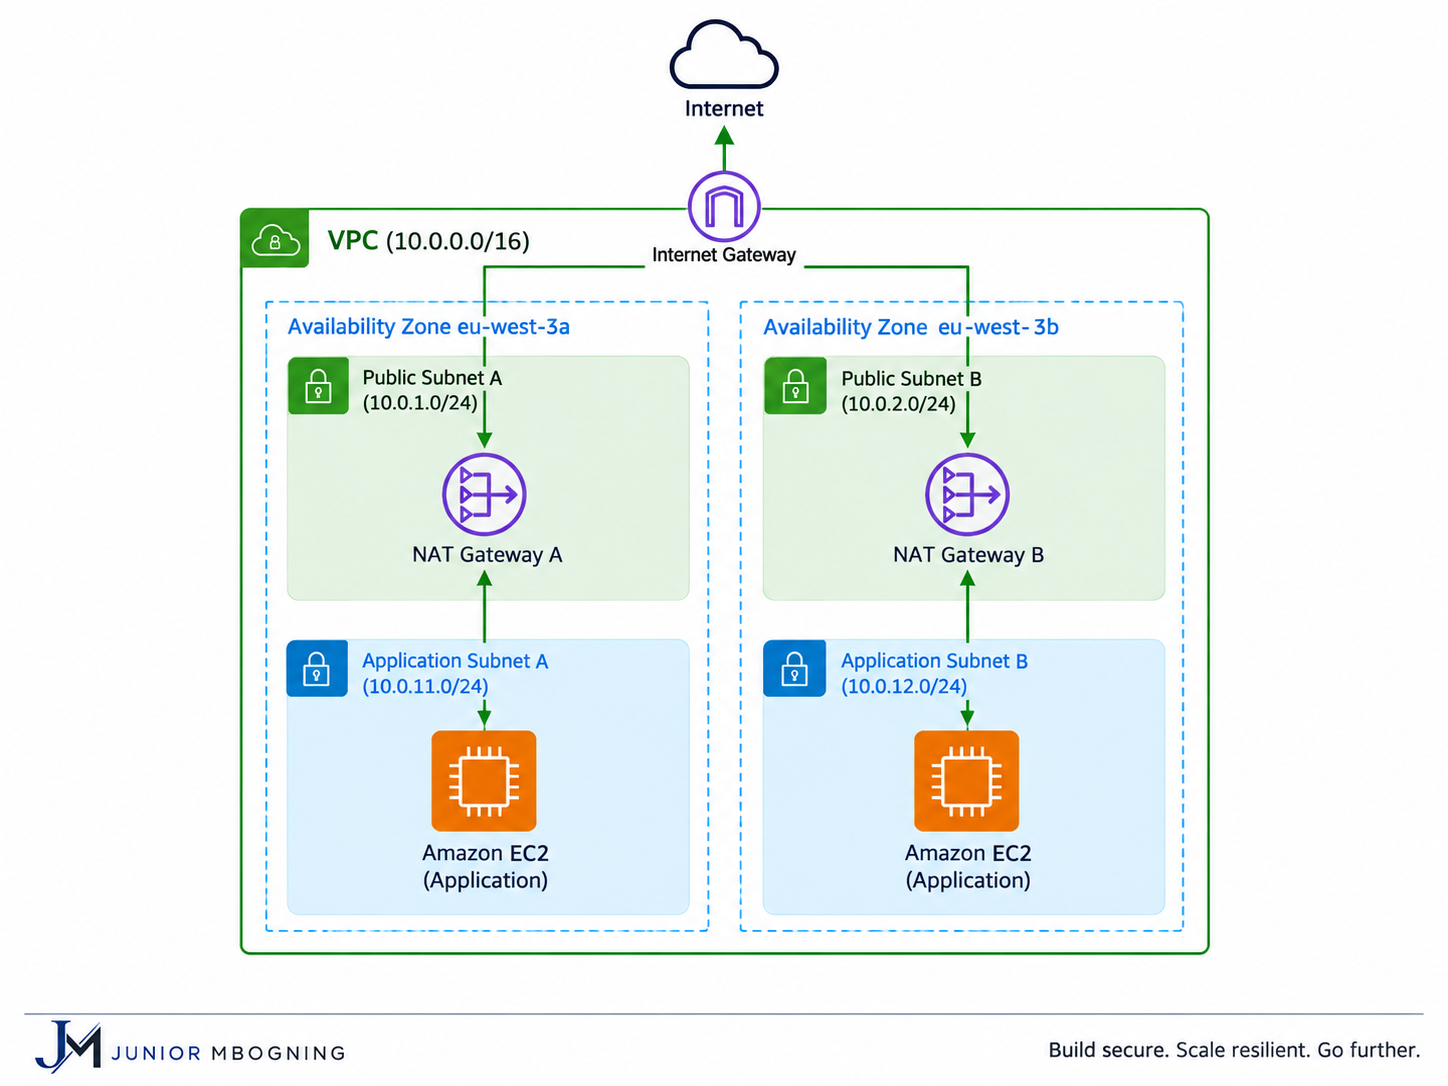
Pour les services AWS, une NAT Gateway n'est pas toujours nécessaire. Un Gateway VPC Endpoint vers S3 permet de conserver le trafic dans le réseau AWS et évite de facturer inutilement la sortie NAT.
Les Security Groups expriment l'intention de connectivité
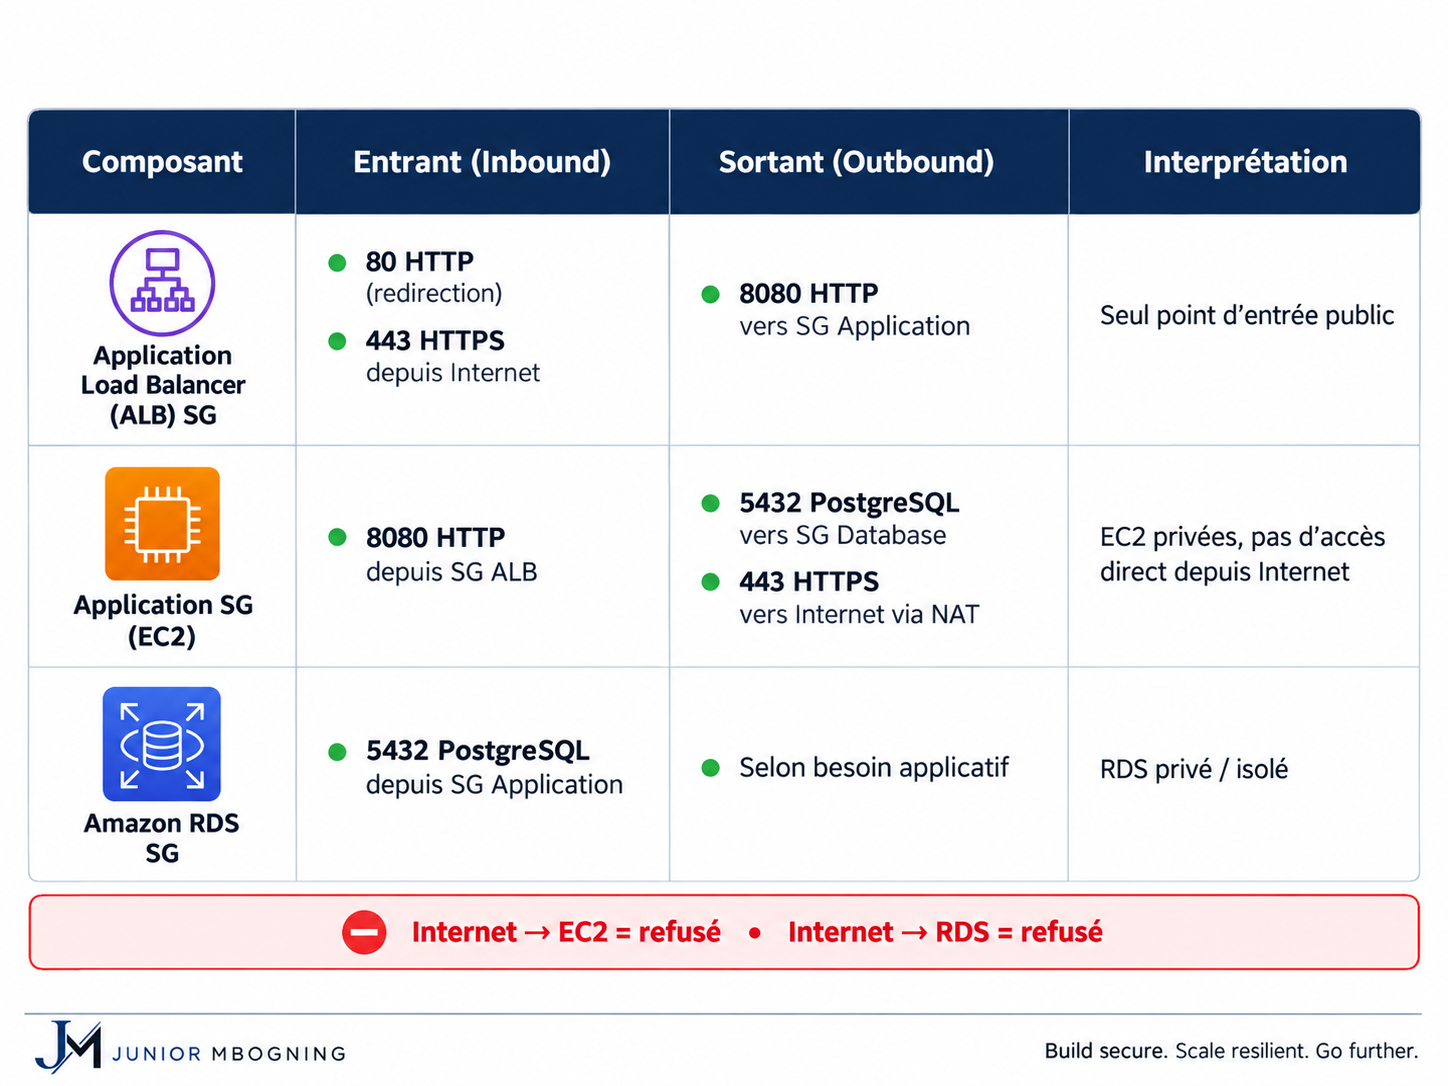
La politique de sécurité peut se résumer ainsi :
Internet -> ALB:443
ALB      -> EC2:8080
EC2      -> RDS:5432
L'application accepte le port 8080 uniquement depuis le Security Group de l'ALB. RDS accepte 5432 uniquement depuis le Security Group applicatif. Les références de Security Groups sont plus robustes que des plages CIDR larges, car elles suivent directement les dépendances entre les composants.
resource "aws_security_group" "application" {
  name   = "production-app-sg"
  vpc_id = aws_vpc.main.id

  ingress {
    description     = "Application traffic from ALB"
    protocol        = "tcp"
    from_port       = 8080
    to_port         = 8080
    security_groups = [aws_security_group.alb.id]
  }
}
Les Security Groups sont stateful : les paquets de réponse sont autorisés sans règle de retour supplémentaire. Les tests doivent néanmoins vérifier les refus aussi bien que les autorisations : Internet vers EC2 et Internet vers RDS doivent échouer.
Une flotte remplaçable plutôt que des serveurs à réparer
L'ALB ne s'intéresse pas à l'état running d'une instance. Il vérifie la santé de l'application au moyen d'un endpoint, par exemple /health. Une machine peut être allumée alors que Nginx, le runtime ou l'application elle-même ne répondent plus.
L'Auto Scaling Group maintient une capacité minimale de deux instances. Lorsqu'une cible devient unhealthy, l'ALB cesse de lui envoyer des requêtes. Le groupe crée ensuite une nouvelle instance pour retrouver la capacité attendue. Cette mécanique suppose que l'instance soit remplaçable : ni fichiers utilisateurs, ni sessions critiques, ni configuration modifiée à la main ne doivent y rester.
Le test révélateur consiste à arrêter Nginx sans arrêter EC2. Si /health échoue, la cible doit sortir du trafic et être remplacée. Une capture de deux instances vertes ne démontre pas ce comportement ; une panne contrôlée, si.
RDS Multi-AZ protège la disponibilité, pas les lectures
RDS Multi-AZ maintient une standby synchrone dans une autre zone de disponibilité. Le mécanisme améliore la disponibilité et permet le failover, mais la standby ne traite pas les lectures applicatives. Pour du read scaling, il faut étudier les read replicas ou un Multi-AZ DB cluster selon le moteur et le workload.
La base reste dans ses subnets dédiés, sans exposition publique. Les secrets ne doivent pas être dispersés dans le code ou dans des variables Terraform manipulées trop largement. Lorsque le cas d'usage le permet, laisser RDS gérer le mot de passe maître dans Secrets Manager réduit le risque de l'exposer dans le state Terraform.
Multi-AZ ne remplace pas les sauvegardes. Une erreur de données est répliquée avec la même efficacité qu'une écriture valide. Les sauvegardes automatisées, le point-in-time recovery et des restaurations testées restent donc indispensables.
Terraform, revue et exploitation
Terraform rend l'infrastructure reproductible et soumet les changements à la revue de code. Il ne rend pas un changement sûr par nature. C'est pourquoi terraform plan est une étape importante : il permet d'identifier les destructions, les routes modifiées, les nouveaux accès réseau et les changements RDS susceptibles de provoquer un remplacement.
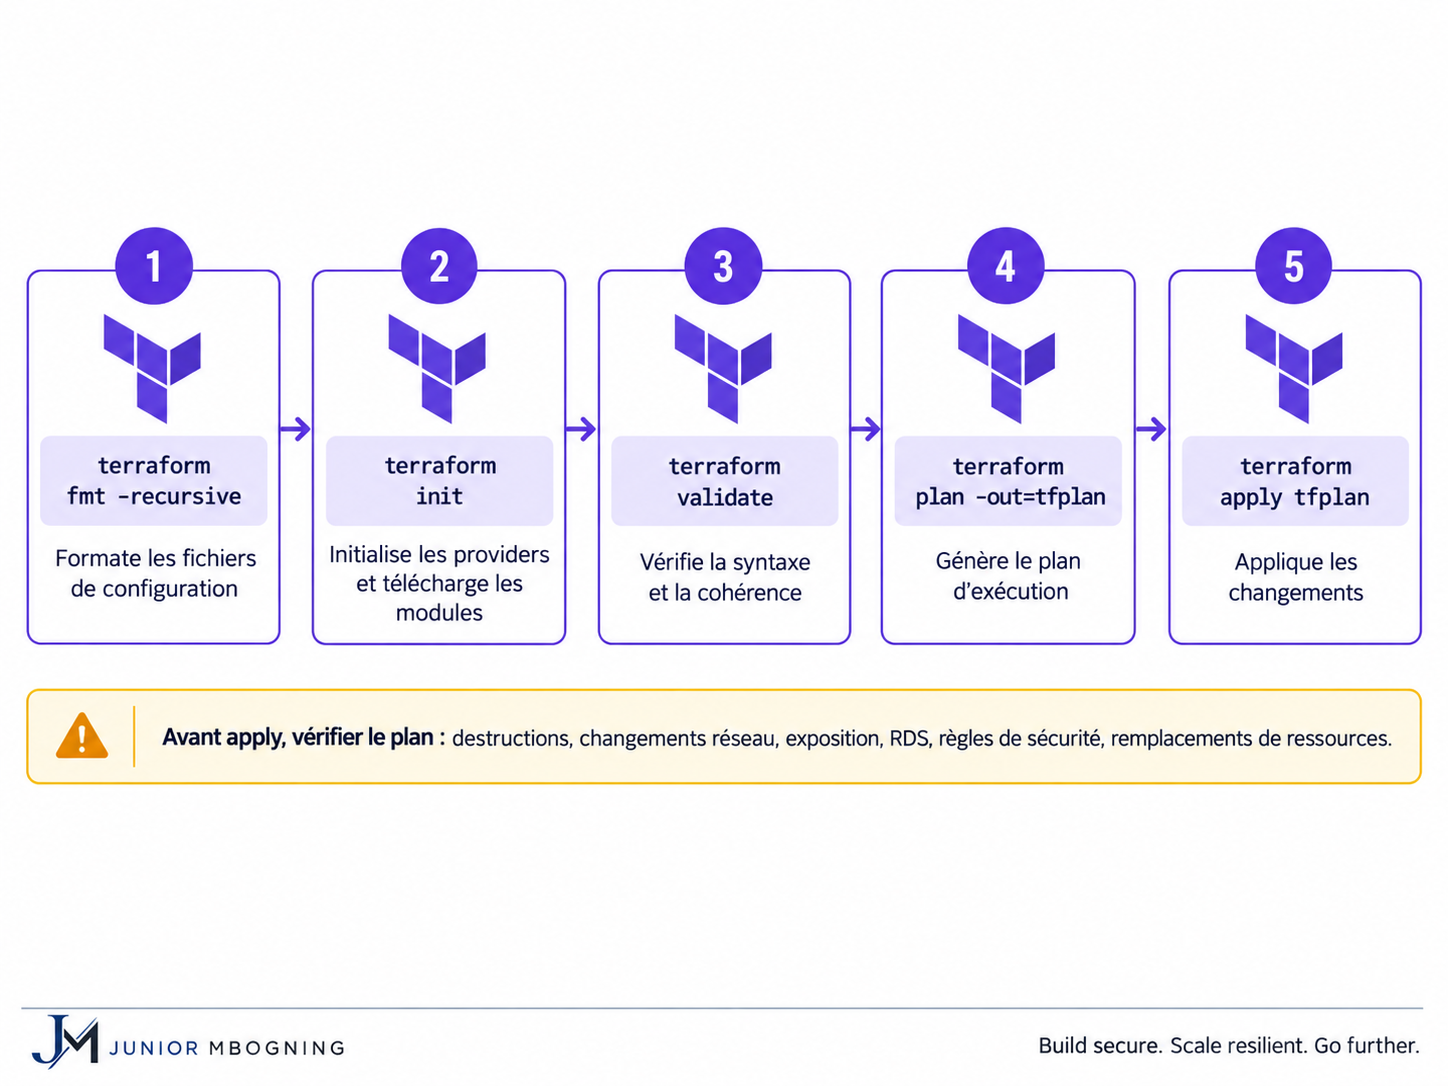
En production, le state doit être distant, chiffré et soumis à des contrôles d'accès stricts. Les déploiements doivent passer par une pipeline CI/CD qui utilise OIDC plutôt que des clés d'accès longue durée.
Valider le comportement attendu, y compris en échec
L'application doit répondre, mais les chemins interdits doivent également être absents :
Internet -> ALB:443  : autorisé
ALB -> EC2:8080      : autorisé
EC2 -> RDS:5432      : autorisé
Internet -> EC2:8080 : refusé
Internet -> RDS:5432 : refusé
Reachability Analyzer et les VPC Flow Logs servent à vérifier cette intention. Je teste ensuite le remplacement d'une instance, la montée en charge, le temps nécessaire pour qu'une nouvelle cible devienne saine et la récupération de l'application pendant un failover RDS.
La question utile n'est pas seulement « le système est-il hautement disponible ? ». C'est « lorsqu'un composant tombe, que voit l'utilisateur et pendant combien de temps ? ».
Conclusion
Une architecture AWS 3-tiers se juge moins à son diagramme qu'à son comportement sous contrainte. La segmentation réseau, les Security Groups, l'Auto Scaling et RDS Multi-AZ n'ont d'intérêt que s'ils produisent un service prévisible lorsqu'un composant échoue.
Le design présenté ici n'est pas une recette universelle. Une application interne peu critique n'a pas le même niveau d'exigence qu'une plateforme transactionnelle. Les compromis dépendent toujours du risque accepté et du coût réel d'une indisponibilité.
Discussion
Commentaires
Les lecteurs peuvent réagir, poser une question ou prolonger l'échange. Une connexion GitHub est demandée pour publier un commentaire.